

Daftar isi
- Masalah Klasik dalam Regresi
- Kenapa Uji Asumsi Klasik di SPSS Terasa Panjang?
- Cara Cepat: Uji Asumsi Klasik dengan Rapid Regression
- Langkah 1: Unggah file Excel
- Langkah 2: Pilih variabel dependen dan independen
- Langkah 3: Klik Run Regression Analysis
- Cara Membaca Hasil Rapid Regression
- Tab Regression Summary
- Tab Assumption Tests
- Tab Diagnostic Plots
- Contoh Menulis Hasil Uji Asumsi Klasik di Skripsi
- Bila Ada Asumsi yang Tidak Terpenuhi
- Pertanyaan yang Sering Diajukan
- Uji asumsi klasik apa saja?
- Apakah regresi linear sederhana perlu uji multikolinearitas?
- Yang diuji normalitas itu data atau residual?
- Apakah data cross section perlu uji autokorelasi?
- Apakah Rapid Regression perlu instal Python?
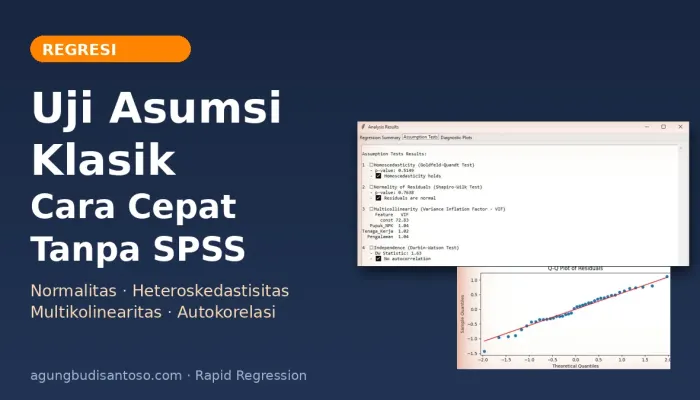
Jawaban singkatnya: uji asumsi klasik adalah serangkaian uji untuk memastikan model regresi linear layak dipakai. Ada empat uji utama: normalitas residual, heteroskedastisitas, multikolinearitas, dan autokorelasi. Di SPSS, keempatnya dikerjakan lewat beberapa menu dan beberapa kali proses. Dengan Rapid Regression, cukup unggah file Excel, pilih variabel, klik satu tombol, dan keempat hasil uji keluar bersama grafiknya.
Masalah Klasik dalam Regresi
Regresi linear berganda dengan metode OLS (ordinary least squares) hanya memberi hasil yang bisa dipercaya bila beberapa syarat terpenuhi. Kalau syarat ini dilanggar, koefisien bisa bias, nilai signifikansi menyesatkan, dan kesimpulan skripsi bisa dipertanyakan penguji. Itulah sebabnya hampir setiap bab hasil penelitian kuantitatif memuat subbab “uji asumsi klasik”.
| Uji | Yang diperiksa | Alat uji yang umum | Lolos bila |
|---|---|---|---|
| Normalitas | Residual berdistribusi normal | Shapiro–Wilk, Kolmogorov–Smirnov, Q-Q plot | p-value > 0,05 |
| Heteroskedastisitas | Varians residual konstan | Goldfeld–Quandt, Glejser, Breusch–Pagan, scatterplot | p-value > 0,05 |
| Multikolinearitas | Antar-variabel bebas tidak saling berkorelasi kuat | VIF dan tolerance | VIF < 10 (yang ketat: < 5) |
| Autokorelasi | Residual tidak saling berkorelasi antarurutan data | Durbin–Watson | DW di sekitar 2 (aturan praktis 1,5–2,5) |
Sebagian buku juga memasukkan uji linearitas. Penjelasan lebih dalam tiap uji ada di uji asumsi klasik bagian 1 dan bagian 2.
Kenapa Uji Asumsi Klasik di SPSS Terasa Panjang?
SPSS tidak punya satu tombol “uji asumsi klasik”. Setiap uji dikerjakan di menu yang berbeda, dan beberapa uji butuh hasil dari uji sebelumnya:
- Regresi dan simpan residual: Analyze → Regression → Linear, lalu centang Save → Unstandardized residuals.
- Normalitas: residual yang tersimpan diuji lagi lewat Analyze → Nonparametric Tests → Legacy Dialogs → 1-Sample K-S atau Descriptive Statistics → Explore → Normality plots with tests.
- Heteroskedastisitas (Glejser): buat variabel baru Transform → Compute berisi nilai mutlak residual, lalu jalankan regresi lagi dengan variabel itu sebagai dependen.
- Multikolinearitas: kembali ke dialog regresi, Statistics → Collinearity diagnostics.
- Autokorelasi: Statistics → Durbin-Watson, lalu cocokkan dengan tabel dL dan dU.
- Grafik: Plots, isi ZPRED dan SRESID untuk scatterplot residual.
Totalnya bisa belasan dialog dan tiga sampai empat kali proses. Satu salah klik, misalnya lupa menyimpan residual, dan Anda harus mengulang dari awal. Ini yang sering membuat mahasiswa kehabisan waktu menjelang seminar hasil.
Cara Cepat: Uji Asumsi Klasik dengan Rapid Regression
Rapid Regression adalah aplikasi Windows yang saya kembangkan untuk memangkas proses itu. Isinya regresi OLS beserta keempat uji asumsi klasik dan grafik diagnostik, dalam satu klik. Aplikasi berbentuk file .exe, jadi tidak perlu memasang Python atau SPSS.
Untuk latihan, unduh data contoh produktivitas bawang merah (Excel). Data ini berisi 40 petani dengan variabel Produktivitas (ton/ha), Pupuk_NPK (kg/ha), Tenaga_Kerja (HOK/ha), dan Pengalaman (tahun). Data bersifat simulasi untuk latihan, bukan hasil survei.
Langkah 1: Unggah file Excel
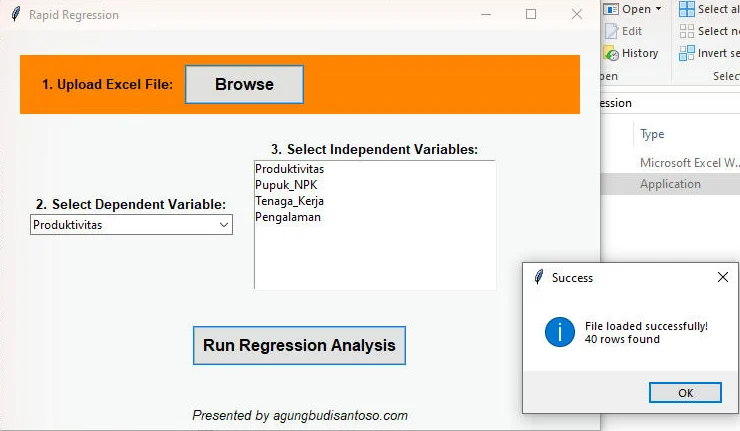
Klik Browse, lalu pilih file .xlsx. Baris pertama harus berisi nama variabel, dan sebaiknya nama variabel ditulis tanpa spasi (pakai garis bawah, misalnya Tenaga_Kerja).
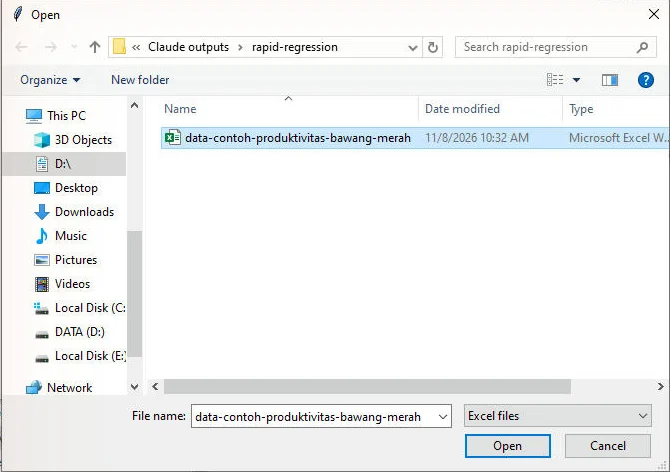
Aplikasi membaca semua kolom berisi angka dan menampilkan jumlah baris data. Kolom teks, seperti kode petani, otomatis diabaikan.
Langkah 2: Pilih variabel dependen dan independen
Di kolom kiri, pilih variabel terikat (Y), yaitu Produktivitas. Di kotak kanan, klik variabel bebas (X) satu per satu: Pupuk_NPK, Tenaga_Kerja, Pengalaman. Variabel yang terpilih berwarna biru. Jangan ikut memilih variabel Y di kotak kanan.
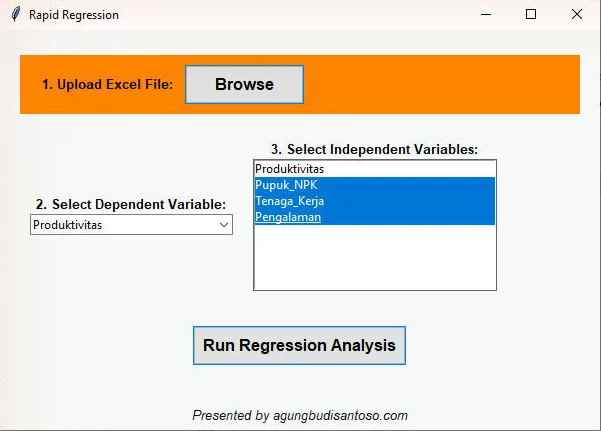
Langkah 3: Klik Run Regression Analysis
Jendela hasil terbuka dengan tiga tab: Regression Summary, Assumption Tests, dan Diagnostic Plots.
Cara Membaca Hasil Rapid Regression
Tab Regression Summary
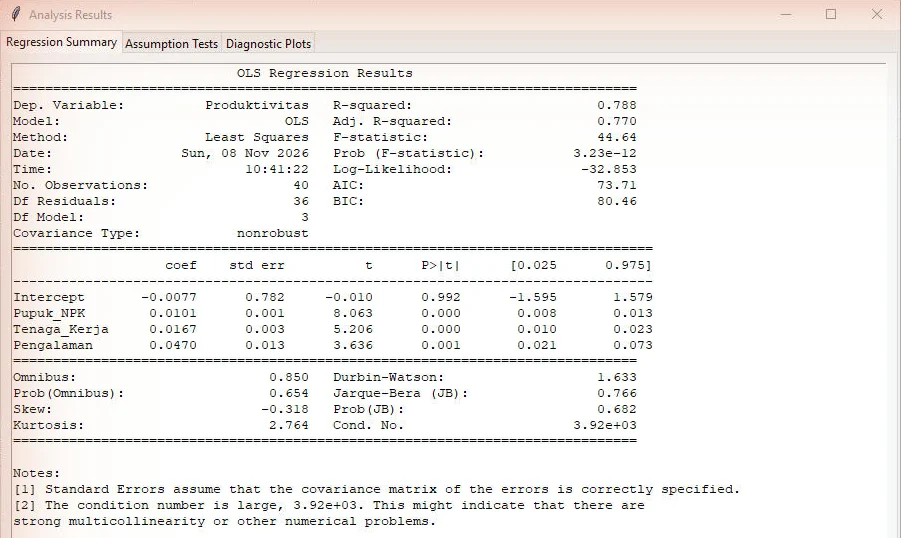
- R-squared 0,788: 78,8% variasi produktivitas dijelaskan oleh ketiga variabel. Arti angka ini dibahas di memahami R square.
- Prob (F-statistic) 3,23e-12: jauh di bawah 0,05, jadi model signifikan secara simultan.
- P>|t|: ketiga variabel signifikan (p ≤ 0,001). Setiap tambahan 10 kg NPK per hektar menaikkan produktivitas sekitar 0,10 ton/ha. Setiap tambahan 1 HOK menaikkan sekitar 0,017 ton/ha, dan setiap tambahan 1 tahun pengalaman sekitar 0,047 ton/ha.
- Catatan “condition number is large”: peringatan ini muncul karena satuan variabel berbeda jauh (pupuk ratusan kg, pengalaman puluhan tahun). Peringatan ini bukan bukti multikolinearitas. Bukti yang dipakai tetap VIF di tab berikutnya.
Tab Assumption Tests
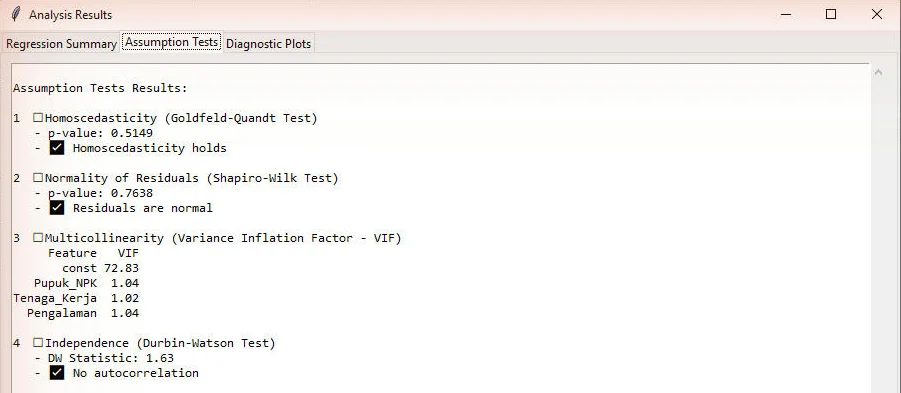
| Uji | Hasil | Kesimpulan |
|---|---|---|
| Heteroskedastisitas (Goldfeld–Quandt) | p = 0,5149 | p > 0,05, varians residual homogen (homoskedastis) |
| Normalitas residual (Shapiro–Wilk) | p = 0,7638 | p > 0,05, residual berdistribusi normal |
| Multikolinearitas (VIF) | 1,02–1,04 | Semua VIF jauh di bawah 10, tidak ada multikolinearitas |
| Autokorelasi (Durbin–Watson) | DW = 1,63 | Dalam rentang 1,5–2,5 |
Tentang baris const 72.83 di tabel VIF: baris ini adalah konstanta (intersep), bukan variabel penelitian. Nilainya memang selalu besar karena kolom konstanta ikut “berkorelasi” dengan rata-rata semua variabel lain. Abaikan baris ini. Yang dibaca hanya VIF variabel bebas.
Tentang Durbin–Watson: aturan praktis 1,5–2,5 memudahkan pembacaan. Kalau dosen meminta pengujian dengan tabel, untuk n = 40 dan 3 variabel bebas nilai dL = 1,338 dan dU = 1,659 (taraf 5%). Nilai 1,63 jatuh di antara keduanya, yang secara formal disebut daerah ragu-ragu. Ingat juga bahwa autokorelasi terutama penting untuk data runtun waktu. Data contoh ini adalah data cross section (40 petani pada satu waktu), sehingga urutan baris tidak bermakna dan uji autokorelasi tidak menjadi masalah utama.
Tab Diagnostic Plots
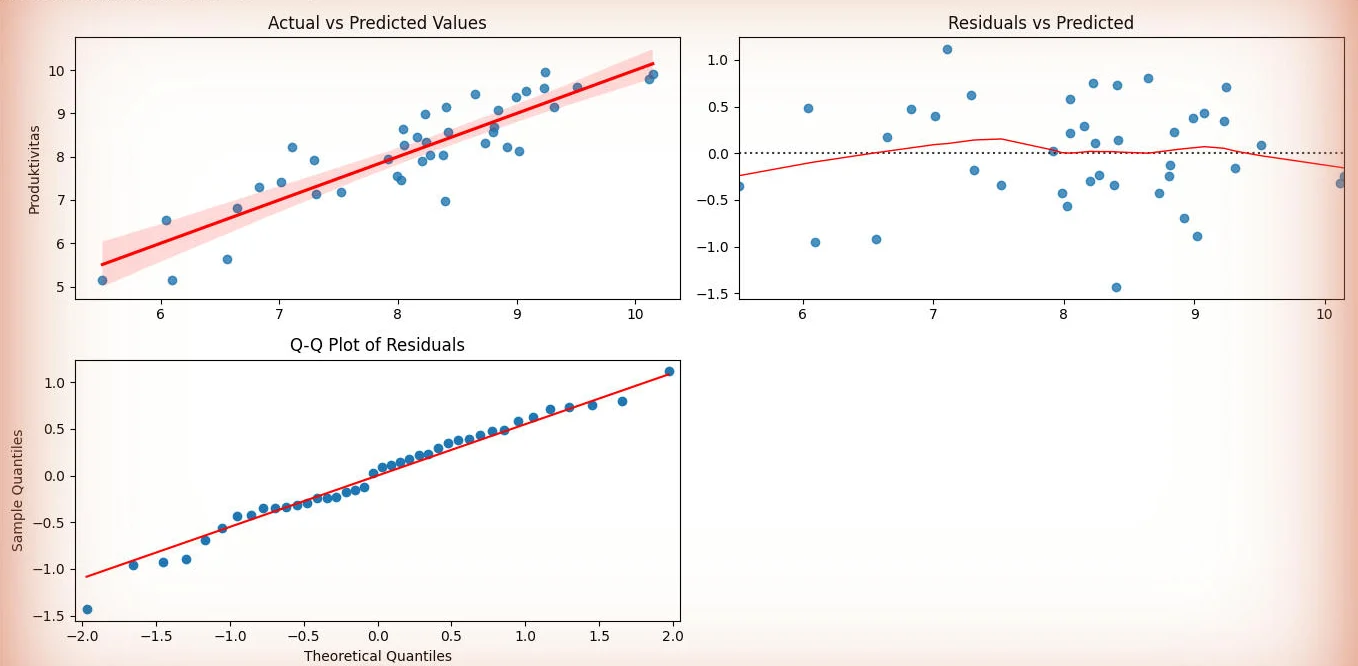
- Actual vs Predicted: titik mengikuti garis merah, artinya prediksi model dekat dengan data asli.
- Residuals vs Predicted: titik menyebar acak di sekitar nol tanpa pola corong. Ini konsisten dengan homoskedastisitas. Contoh pola yang bermasalah ada di contoh heteroskedastisitas.
- Q-Q Plot: titik residual mengikuti garis diagonal, mendukung hasil Shapiro–Wilk bahwa residual normal.
Contoh Menulis Hasil Uji Asumsi Klasik di Skripsi
Hasil di atas bisa dilaporkan di bab hasil penelitian kira-kira seperti ini:
Uji asumsi klasik menunjukkan model regresi memenuhi syarat BLUE. Uji Shapiro–Wilk terhadap residual menghasilkan p = 0,764 (> 0,05) sehingga residual berdistribusi normal. Uji Goldfeld–Quandt menghasilkan p = 0,515 (> 0,05) sehingga tidak terjadi heteroskedastisitas. Nilai VIF ketiga variabel bebas berkisar 1,02–1,04 (< 10) sehingga tidak terjadi multikolinearitas. Nilai Durbin–Watson sebesar 1,63 berada pada rentang 1,5–2,5.
Sebutkan juga nama uji yang dipakai. Sebagian penguji terbiasa dengan Kolmogorov–Smirnov dan Glejser dari SPSS. Shapiro–Wilk dan Goldfeld–Quandt adalah uji yang sama-sama sah, dan Shapiro–Wilk justru dianjurkan untuk sampel kecil.
Bila Ada Asumsi yang Tidak Terpenuhi
- Residual tidak normal: lihat uji normalitas dan tips jika data tidak normal.
- Heteroskedastisitas: lihat pengertian dan cara mengatasi heteroskedastisitas.
- VIF tinggi: lihat VIF: arti, batas nilai, dan cara menghitung serta dampak multikolinearitas.
- Ingin memahami kodenya: aplikasi ini dibangun dengan Python. Versi kodenya bisa dipelajari di coding Python regresi berganda dan uji asumsi klasik.
Ingin mencoba Rapid Regression dengan data skripsi Anda? Uji asumsi klasik yang biasanya memakan waktu satu sore bisa selesai dalam hitungan detik.
Pertanyaan yang Sering Diajukan
Uji asumsi klasik apa saja?
Empat uji utama: normalitas residual, heteroskedastisitas, multikolinearitas, dan autokorelasi. Sebagian buku menambahkan uji linearitas sebagai uji kelima.
Apakah regresi linear sederhana perlu uji multikolinearitas?
Tidak. Multikolinearitas hanya relevan bila variabel bebasnya dua atau lebih. Regresi sederhana dengan satu X cukup diuji normalitas, heteroskedastisitas, dan (untuk data runtun waktu) autokorelasi.
Yang diuji normalitas itu data atau residual?
Dalam regresi, yang diuji adalah residual, bukan masing-masing variabel. Rapid Regression langsung menguji residual dengan Shapiro–Wilk.
Apakah data cross section perlu uji autokorelasi?
Uji autokorelasi terutama dibutuhkan untuk data runtun waktu. Pada data cross section, urutan baris bisa diacak tanpa mengubah makna data, sehingga hasil Durbin–Watson kurang bermakna. Tetap laporkan bila diminta pembimbing.
Apakah Rapid Regression perlu instal Python?
Tidak. Rapid Regression berbentuk file aplikasi Windows (.exe) yang langsung dijalankan. Saat pertama dibuka, aplikasi butuh beberapa detik untuk memuat.

Diskusi
Belum ada komentar. Punya pertanyaan tentang materi ini? Tulis di bawah — saya usahakan menjawab.